RAG / 系統整合
把 YouTrack 接進 RAG:第二來源的同步、檢索與補讀
從獨立索引、精確專案映射、雙重可見性檢查,到來源融合與受限工具迴圈,拆解第二來源真正落地時遇到的工程問題。
實作紀錄期間:2026-10-06 至 2026-10-08;依實作紀錄與版本程式核對
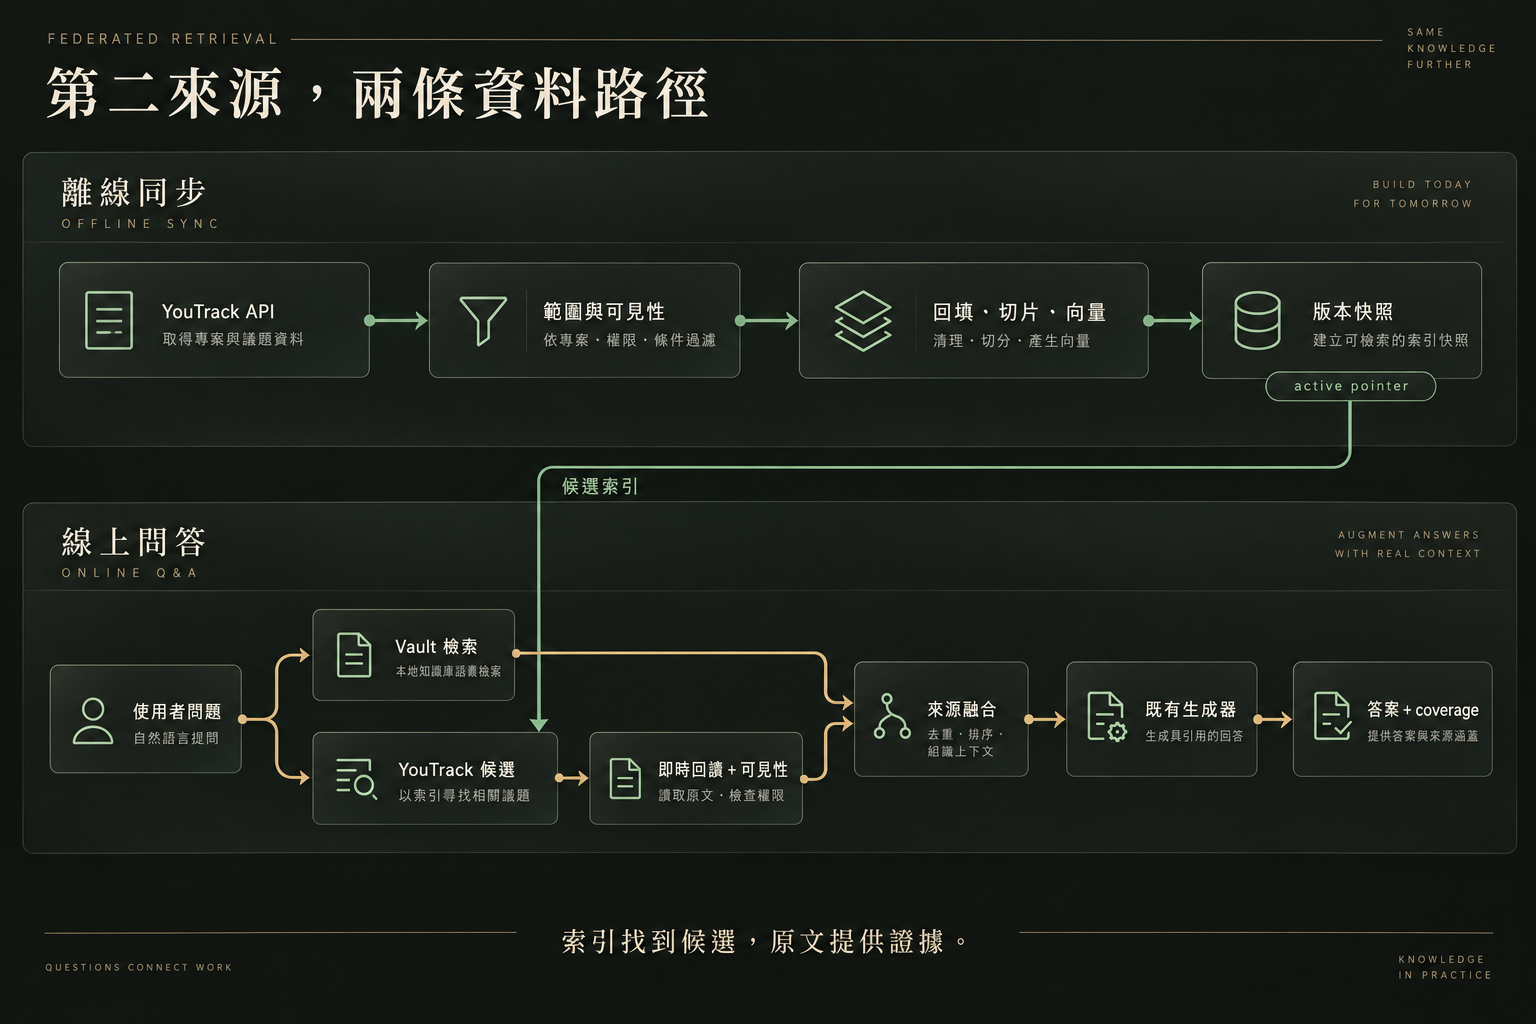
原本只有 Markdown 的知識庫,接上 YouTrack 之後,多了另一種資料生命週期:議題持續更新、留言有各自的可見性、專案範圍會變動,搜尋結果也不等於回答當下的原文。這次實作把第二來源拆成離線同步與線上問答兩條路,再逐步加入模型自主補讀。
這篇記錄三個階段:先建立受控的第二來源索引,再接進聯合檢索,最後改為透過 API 呼叫模型,加入有上限的工具迴圈。內容根據實作紀錄與對應程式整理;所有範例識別碼、資料內容與路徑均為示意,不包含組織名稱或內部業務知識,也不代表此刻正式服務的即時量測。
01|先把第二來源留在自己的儲存邊界
Markdown 沿用既有向量庫與關鍵詞檢索。YouTrack 則有自己的快照、切片、embedding 快取與 NumPy 餘弦相似度索引,沒有直接灌進原本的 Qdrant collection。兩條檢索路徑直到線上查詢才融合。
這讓重建第二來源、調整切片或歷史回填時,不必重建原本的知識庫索引;也能分別停用同步、聯合檢索與答案生成。代價是必須自己處理跨來源排序、健康狀態與證據版本,不能把「同一個搜尋框」誤認成「同一套資料一致性」。
| 路徑 | 讀什麼 | 輸出 | 更新時機 |
|---|---|---|---|
| Markdown 檢索 | 既有內容索引 | 帶路徑與來源資訊的 chunk | 文章同步後 |
| YouTrack 離線同步 | 專案、議題、描述與留言 | 版本快照、切片與向量 | 排程增量與歷史回填 |
| YouTrack 線上回讀 | 候選議題的最新可讀原文 | 可引用的描述與留言 | 回答前/工具補讀時 |
| 來源融合 | 兩路候選與證據狀態 | 有來源標記的上下文 | 每次問答 |
圖中呈現的是核心資料路徑。後續的 API 工具迴圈是在這些受控入口上搜尋與補讀,沒有讓模型直接操作索引檔案或任意存取外部網址。
02|專案名稱不能拿來當授權條件
映射規則使用資料夾代碼與 YouTrack shortName 的完整相等比對。先做 NFKC 正規化,再取第一個連字號或底線之前的代碼;YouTrack 端依既定規則補前導零。顯示名稱只給人看,穩定 project ID 才用來鎖定身分。
# 簡化示意:完整相等,不用名稱猜測,也不用 startswith。
folder_code = normalize_nfkc(folder_name).split('-', 1)[0].split('_', 1)[0]
expected_code = '0' + normalize_nfkc(project_short_name)
if folder_code != expected_code:
    return NO_MATCH

# 已建立映射後,另外核對持久化的 project ID pin。
assert_pinned_identity(folder_code, stable_project_id)
例如示意代碼 0240 與 0240X 必須視為不同範圍。同碼資料夾可能只是別名,應合併同步;同一代碼卻換成另一個 project ID,則要拒絕沿用舊映射。範圍快照缺失或損壞時回傳空集合,不能退回某個歷史帳號的專案清單。
新資料夾可觸發歷史回填,但這也代表資料夾管理會影響來源範圍。刪掉第一篇文章,不等於刪掉資料夾,更不等於撤銷已匯入的歷史資料;這些事件要分開定義。
03|可見性要檢查兩次,而且留言也要查
實作採用共享服務帳號讀取 YouTrack。可同步範圍是「帳號看得見」「資料夾映射允許」「議題與留言符合可見性條件」的交集。共享帳號看得見的集合,不應假設等於任何個人帳號的子集合。
本次入口只接受 UnlimitedVisibility;缺少 visibility 欄位同樣排除。同步時檢查一次,線上回讀時再檢查一次,兩邊共用同一個判斷函式,避免離線與線上的規則逐漸分歧。
# 簡化示意:議題通過,不代表每則留言都通過。
def unrestricted(item):
    visibility = item.get('visibility')
    return isinstance(visibility, dict) and visibility.get('$type') == 'UnlimitedVisibility'

if not unrestricted(issue):
    return NO_EVIDENCE
comments = [item for item in comments if unrestricted(item)]
過濾必須發生在內容進入模型與稽核紀錄之前;稽核只記必要的識別資訊與狀態,不記被排除內容。這是共享來源的資料邊界,不是逐使用者 YouTrack ACL 模擬器;若要支援個人權限,必須另外建立身分與授權模型。
04|先發佈增量,再處理昂貴的歷史回填
同步每次重新計算有效映射。既有專案的增量更新先完成並發佈,再於有界工作量內處理新增範圍的歷史回填。回填成功的資料在獨立的 promotion 步驟進入後續可用版本,避免一次回填失敗把已成功的增量更新一起撤回。
runtime/
  generations/
    generation-a/    # 已可用版本
    generation-b/    # 建置與驗證中的版本
  active-pointer    # 查詢端讀取的版本指標

build -> validate -> promote
失敗:保留原本 active;記錄本次失敗範圍
向量快取依內容 digest 重用,切片參數則明確記錄。本次版本採短文本上限 1,800 字元、長文本視窗 1,100 字元、重疊 250 字元;這些是字元數,不是 token 數。已測快照能在不截斷的情況下嵌入,不代表未來所有文件都一定能放進模型限制。
同步工作放進 asyncio.to_thread,讓主事件迴圈仍能回應狀態請求。不過 embedding 服務仍可能共用運算資源,所以「健康檢查正常、問答變慢」可能是資源競爭;移出事件迴圈不會自動消除排隊時間。
05|索引用來找候選,原文才是回答證據
離線向量索引找出候選 issue ID 後,線上路徑用受控帳號重新讀取描述與留言,再套用可見性檢查。這避免把幾小時前的索引片段直接當作目前狀態,也能在權限改變時排除原本可讀、現在不可讀的內容。
{
  "source_type": "youtrack",
  "source_id": "DEMO-42",
  "snapshot_id": "generation-a",
  "indexed_at": "2026-10-08T01:00:00Z",
  "fetched_at": "2026-10-08T01:04:00Z",
  "evidence_state": "live_read"
}
indexed_at 與 fetched_at 回答不同問題:前者說明候選索引版本,後者說明這次證據何時讀取。即時回讀也不能保證完整召回;新議題若尚未進索引,仍可能連候選都沒有。回讀失敗必須留下來源缺口,不能默默把舊片段改標成最新原文。
部署後還遇過另一種邊界錯誤:快照移到 repository 外的 runtime 目錄,程式卻仍呼叫 relative_to(repo),導致檢索成功後在組裝來源標籤時出錯。修正是用 runtime 作為快照標籤的基準,公開引用使用 snapshot ID,不輸出機器上的絕對路徑。
06|融合的不只是分數,還有來源配額與證據身分
兩個來源的向量分數不宜直接相加。本次版本使用依來源排名計算的融合分數:每路先去重與截取配額,再以 1 / (60 + rank) 排序,最後取總量上限。YouTrack 依 issue ID 去重,Vault 依 chunk ID 或路徑辨識。
# 演算法示意;rank 從 1 開始。
for source, hits in groups.items():
    unique_hits = deduplicate_within_source(hits)
    for rank, hit in enumerate(unique_hits[:quota], start=1):
        merged.append((1 / (60 + rank), source, hit))
return sorted(merged, key=lambda item: item[0], reverse=True)[:limit]
這是來源間的排名融合,不能和 Vault 內部的向量/關鍵詞混合排序混為一談。若 Vault 筆記是某張議題的整理版,還要保留 related_issue_ids 與轉述關係,避免把一份原始證據的兩種表述當成兩份獨立佐證。
固定配額也造成過回歸:總上限 8、每來源配額 6,會讓只選單一來源的問題最多剩 6 筆。當時先放寬配額處理;更完整的動態配額需要分別驗證單來源與雙來源查詢,不能只測兩路都有結果的情境。
07|來源勾選是一份 API 契約
省略 sources 代表走預設來源策略;明確提供來源清單代表使用者鎖定範圍。即使清單同時包含兩個來源,也不一定與省略參數相同。前後端都拒絕空清單,避免使用者全取消後,後端反而自行擴大搜尋範圍。
| 請求 | 意義 |
|---|---|
| 不帶 sources | 採預設來源策略 |
| sources 為 vault | 明確只查 Vault |
| sources 為 youtrack | 明確只查 YouTrack |
| sources 同時指定兩者 | 明確鎖定這兩個來源 |
| sources 為空陣列 | 輸入錯誤,要求至少選一個 |
答案另外帶 coverage,交代要求查什麼、實際查了什麼、哪些不可用,以及本次限制。以下只是公開化的契約示例,不包含被權限排除的內容或數量。
{
  "requested": ["vault", "youtrack"],
  "searched": ["vault"],
  "unavailable": ["youtrack"],
  "failures": [{"source": "youtrack", "reason": "read_timeout"}],
  "partial": true,
  "limitations": ["本次未取得第二來源的即時原文"]
}
partial 為 false 只表示沒有已知的執行缺口,不是「所有相關資料都找到了」的保證。沒有 coverage 的舊答案,也應顯示狀態未知,不能補成完整成功。
08|從固定檢索,走到透過 API 的受限工具迴圈
最初接入第二來源時,仍保留既有生成器。直接複製另一套 API 摘要流程,不能保證與原本的 SDK 呼叫契約相容;檢索接通、生成器遷移與功能開關,是三個要分開驗證的變更。
後續改為透過 API 呼叫模型,加入搜尋與 read_source 工具。模型能依結果要求補讀,但工具端仍負責來源範圍、可見性、可讀識別碼與輸出上限。YouTrack 與 Vault 的有效範圍也分開解析,避免因為 Vault 找不到唯一資料夾,就連已授權的第二來源也一併拒絕。
| 迴圈限制 | 本次版本設定 | 限制的對象 |
|---|---|---|
| 請求時間 | 60 秒 | 單次問答總時間 |
| 模型呼叫 | 最多 4 次 | 工具迴圈中的模型往返 |
| 工具呼叫 | 最多 8 次 | 搜尋與補讀工作量 |
| 單次輸出 | 2,400 tokens | 每次模型輸出上限 |
| 累計 token 預算 | 應用層未另設 | 仍受上述時間與次數限制 |
取消累計 token 預算,不代表沒有成本上限或可以無限迴圈。用量與成本仍要記錄,超時或到達呼叫次數上限時,答案必須承認沒有完成的部分。
09|最容易漏掉的地方:搜尋到了,模型卻沒看到
一次代表題的 trace 顯示搜尋已回傳 14 筆,但關鍵候選沒有出現在模型收到的工具結果裡。問題出在 compact_result:原本約 5,000 bytes 的壓縮上限把尾端裁掉,而第二來源排序在後面,特別容易整批消失。
修正先把工具結果預算調整到 16,000 bytes,再交錯保留不同來源、優先刪除重複 metadata、保留候選 ID 與標題,並把截斷情形寫入 coverage。這裡的單位是 UTF-8 bytes;中文、標點和 metadata 都會消耗預算,不能拿字元數直接估算。
接著又發現,模型即使知道內容被裁切,仍可能只在答案裡說「可以再讀全文」,卻沒有真的呼叫工具。單靠提示詞要求補讀不足以解決,於是程式在符合條件的下一個非最終回合強制 read_source;讀哪個已核准來源仍由模型選擇,成功後恢復自動選擇工具。
# 簡化示意:仍受總時間、模型次數與工具次數限制。
tool_choice = 'auto'
if requires_source_read and next_turn_allows_tools:
    tool_choice = {
        'type': 'function',
        'function': {'name': 'read_source'}
    }
# 成功補讀後清除 requires_source_read,再回到 auto。
全文補讀本身也有分頁邊界:本次版本每頁限制 12,000 UTF-8 bytes,並限制最多 4,000 字元。工具回傳了內容,不等於整份來源都已讀完;是否還有下一頁、是否截斷,以及來源身分必須一起保留。
10|驗收要分清楚「已接通」與「答得完整」
實作按三個階段落地:先上線抓取與獨立索引,再加入聯合檢索與來源勾選,最後驗證 API 工具迴圈及強制補讀。10 月 8 日的紀錄已包含代表題驗收與開放給已登入使用者,不能再沿用早期「尚未實作自主查詢」的摘要。
| 驗證 | 能證明什麼 | 不能證明什麼 |
|---|---|---|
| 範圍與可見性測試 | 缺欄位、錯映射、受限內容被拒絕 | 所有未來權限異動都已測到 |
| 351 項後端測試 | 本次測試集合的回歸通過 | 所有實際問題都答對 |
| HTTP 權限測試 | 對應測試身分可通過入口 | 每位同事都完成真實 UI 驗收 |
| 代表題完整 trace | 此題串起搜尋、補讀、引用與回答 | 全部問題的召回率與 P95 延遲 |
| 健康狀態與執行版本 | 服務可用、載入預期版本 | 索引內容完整或答案品質達標 |
最有價值的驗收資料是一條能重播的證據鏈:問題與來源選擇、候選清單、工具結果裁切狀態、實際補讀內容、引用來源與最後答案。只看最後一段文字,很難區分是檢索沒找到、壓縮器丟掉、工具沒呼叫,還是模型解讀錯誤。
11|這次實作留下的設計原則
第二來源真正增加的複雜度,在於同步版本、權限與生成上下文必須互相對得起來。獨立索引讓來源可以各自演進;即時回讀補上證據新鮮度;coverage 說明缺口;受限工具迴圈則處理初次檢索不足的情況。
下一輪值得持續驗證的是固定題集的跨來源召回、裁切後候選保留率、全文分頁是否完成,以及同步期間的問答延遲。這些需要查詢 trace 與實測分布,不能用一個成功案例代替。