知識架構 / 系統整合
企業知識庫實作:從 Markdown 到可追溯的 RAG
拆解 Python WebUI、FastAPI、SQLite、Qdrant 與 Codex SDK 的分工,沿著投稿、知識整理、增量索引與串流問答,說明一套知識庫如何真正運作。
實作紀錄期間:2026-07 至 2026-10;依實作紀錄與程式核對
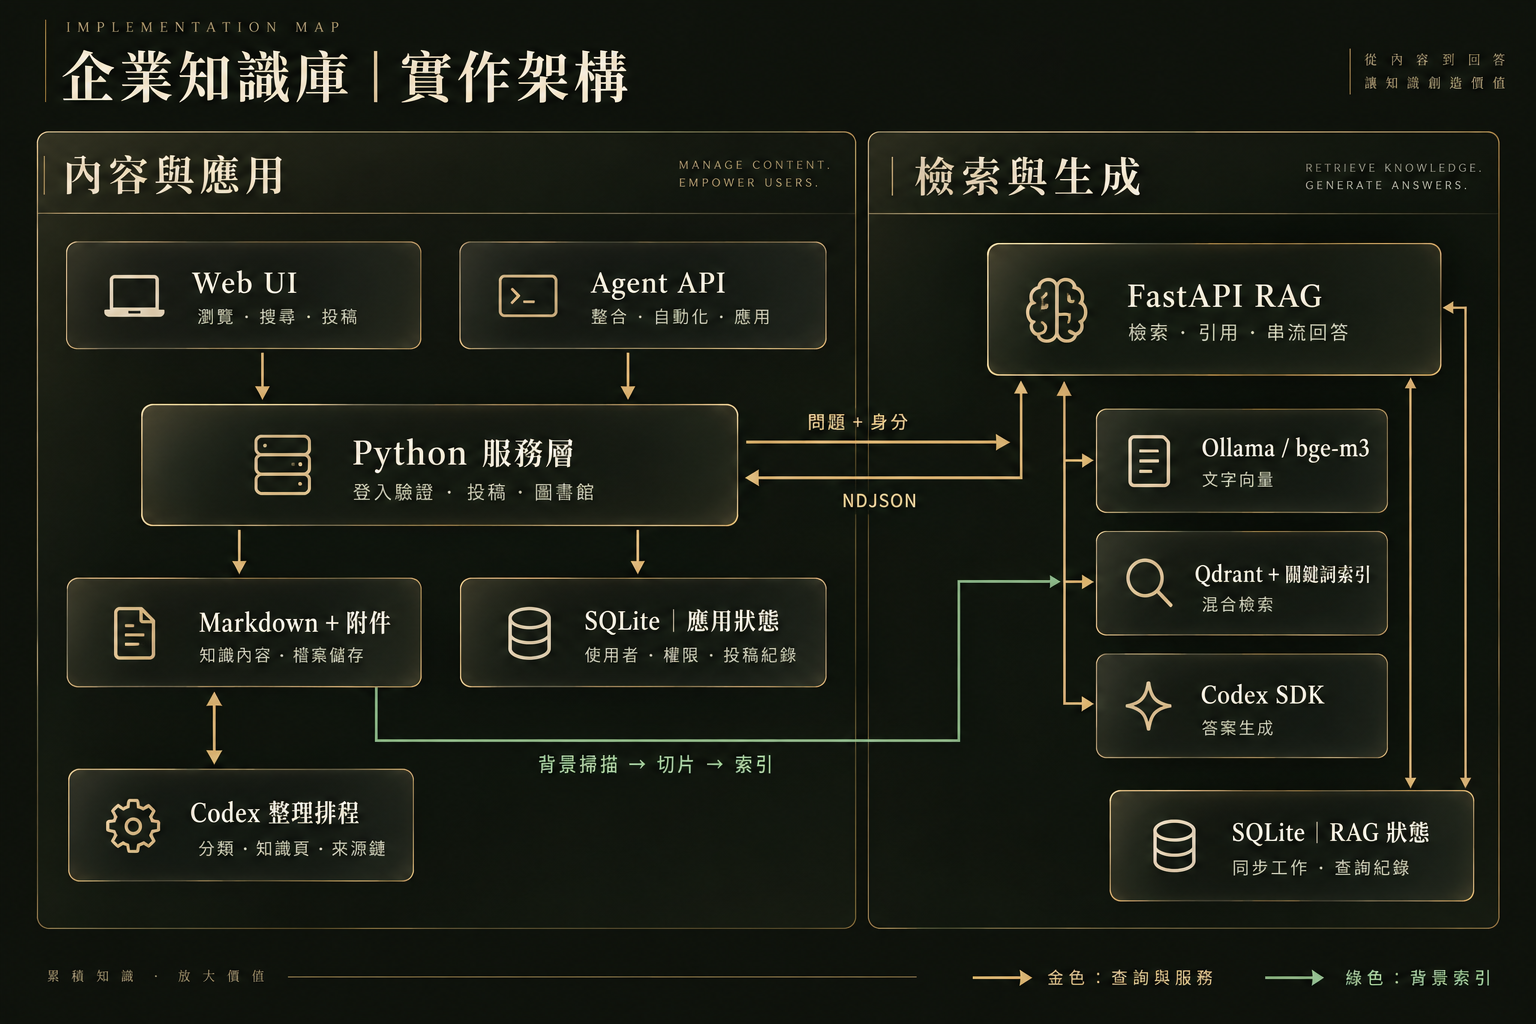
這套知識庫以 Markdown 保存內容,以 Python 提供圖書館、投稿與 API,再把檢索和模型生成放進獨立的 FastAPI 服務。文章本體、使用者狀態、向量索引各有自己的儲存位置;瀏覽文章不需要模型,問答才會進入 RAG 管線。
以下沿著一篇筆記的生命週期,拆開元件、資料契約與處理順序。技術名稱與演算法來自實作;路徑、文章內容、識別碼和 JSON 值均採通用示例,不含組織名稱或內部業務資料。這是對已建置版本的技術複盤,並非正式環境即時狀態報告。
01|實際用了哪些元件
網頁入口與 RAG 是兩個獨立程序。前者管理使用者、文章與操作;後者管理索引、檢索和生成。兩者透過內部 HTTP 契約連接,瀏覽器只接觸網頁服務。
| 元件 | 實作方式 | 負責什麼 |
|---|---|---|
| 網頁前端 | HTML、CSS、JavaScript ES modules | 圖書館、投稿預覽、問答、引用與個人紀錄 |
| WebUI 服務 | Python HTTP handler 與 Application 服務層 | 登入、文章讀寫、分類驗證、權限檢查、RAG proxy |
| 內容儲存 | Markdown、YAML frontmatter、圖片附件 | 保存文章全文、文章屬性與來源 |
| 應用狀態 | SQLite | 文章 registry、Token、收藏、閱讀與管理資料 |
| RAG sidecar | FastAPI 與背景工作 | 增量索引、檢索、問答串流、查詢紀錄 |
| Embedding | Ollama 提供 bge-m3 | 把文件片段與查詢文字轉成向量 |
| 向量搜尋 | Qdrant local mode | 持久保存向量與片段 metadata |
| 關鍵詞搜尋 | 記憶體倒排索引 | 中文詞片段、英文識別碼與精確字串比對 |
| 生成器 | Codex SDK provider | 問題分類與依證據生成答案 |
| RAG 狀態 | 另一份 SQLite | 文件清冊、索引工作、有效片段、查詢與回饋 |
Qdrant 使用本機持久化模式,並不是另架一個向量資料庫叢集。WebUI 的 SQLite 和 RAG 的 SQLite 也不是同一份資料庫:前者服務產品操作,後者服務索引與查詢追蹤。
02|資料怎麼放:文章、狀態與索引分離
程式、知識內容與執行期資料分開存放。下面是簡化後的邏輯目錄,名稱用於說明分工,不是內部部署路徑。
application/                 # WebUI、API 與 RAG 程式
content/
  inbox/                     # 新投稿
  documents/                 # 已分類原始紀錄
  knowledge/                 # 整理後的知識頁
  assets/                    # 圖片與附件
runtime/
  web/app.sqlite             # registry、收藏、Token、事件
  rag/state.sqlite           # 文件、工作、查詢、證據
  rag/qdrant/                # 向量與片段 payload
  logs/                      # 程序與查詢日誌
文章的 frontmatter 描述文章本身。以虛構筆記為例,格式可以像這樣;其中 article_id 由服務管理,不能讓模型任意重配。
title: 背景工作重試的排查筆記
date: 2026-10-08
tags: [排查, 維運]
project: 範例分類
article_id: demo-article-001
收藏用「使用者 ID+文章 ID」建立關係,避免文章改名或移動後斷鏈。掃描器也需要辨識文章從進件區移到正式分類的情況;只在原資料夾找不到檔案,就把它當新文章,會連帶造成收藏、歷史與統計錯接。
實作上的取捨是:可讀內容保留在檔案,快速變動的應用狀態放資料庫。備份必須同時照顧文章、附件和應用資料庫;向量可由來源重建,但重建向量無法還原收藏或查詢歷史。
03|投稿如何落地:驗證、冪等、回讀
投稿有兩個入口。網頁使用者先看預覽再確認;Agent 使用具發布 scope 的 Token 呼叫 API。後者可以直接新增,但不因此取得任意覆寫既有文件的權限。
一筆發布請求的核心資料如下。分類 ID 必須先從服務取得,不能把自然語言分類名稱直接當成有效 ID;範例中的值只是示意。
{
  "category_id": "demo-category",
  "title": "背景工作重試的排查筆記",
  "content": "先記錄失敗階段,再判斷是否能安全重試。",
  "idempotency_key": "demo-publish-20261008-001"
}
服務依序檢查身分、發布權限、分類與 frontmatter 一致性,再配發文章 ID、補入受管投稿資訊,最後以只新增的方式寫入。成功後回傳文章 ID 與內容雜湊,客戶端再讀回全文核對。
| 情況 | 處理方式 | 避免的問題 |
|---|---|---|
| 同一 Token、同一冪等鍵、相同內容重送 | 回傳既有結果 | 網路重試造成重複投稿 |
| 同一冪等鍵換了內容 | 回報衝突 | 用重試修改已發布內容 |
| 分類缺少、不存在或與文章欄位矛盾 | 在落地前拒絕 | 文章和附件寫一半才發現分類錯誤 |
| Token 被撤銷或失去發布資格 | 拒絕操作 | 舊憑證保留不應再有的能力 |
| 選到另一個有效分類 | 仍可能通過 | 存在性檢查無法代替內容判斷 |
圖片與文章同一請求送出,使用 placeholder 對應附件,再由服務按內容雜湊保存及去重。回讀不只驗正文,也要確認每個圖片引用都能找到實際附件。
04|兩種排程:整理知識與更新索引
每日知識整理與 RAG 背景同步,觸發方式和輸出完全不同。前者會改變知識內容,後者主要更新衍生索引,不能用「同步完成」統稱兩件事。
| 流程 | 讀取什麼 | 寫入什麼 | 成功的判定 |
|---|---|---|---|
| Codex 知識整理排程 | 新增/修改來源、刪除事件、既有知識頁 | 分類後紀錄、知識頁、來源鏈與整理報告 | 有效段落均有承接,來源與事件處理完整 |
| RAG 背景同步 | 允許範圍的 Markdown、文件清冊與待辦工作 | 切片、向量、倒排索引、索引版本 | 文件與有效片段一致,失敗工作可追蹤 |
知識整理先處理同批新增與修改,再處理刪除影響,避免先刪舊知識、隔天才補新版本。刪除也不只是移走原檔:若知識頁的某段結論只靠已失效來源支持,就必須更新;其他來源仍能支持的段落則保留。
刪除事件另外保存處理收據。事件尚未成功處理,即使 Git 掃描基準已前進,下一輪仍要重新找到它。處理順序、受管欄位與來源鏈,都是整理排程的一部分,不能只給模型一句「幫我整理」。
05|增量索引:先判斷變更,再計算向量
RAG 維護文件清冊與工作佇列,分辨新增、更新及刪除。文件變更後重新切片;不直接把整個資料夾每次重新 embedding。
切片器先解析 frontmatter,再按 Markdown 標題層級拆段,並辨識程式碼圍欄,避免把程式碼裡的井字號當成文章標題。較長段落再細分;這版切片器以約 700 字元為目標、1,000 字元為上限處理長區塊。這是程式的切片尺度,不是模型 token 限制,也不是通用最佳值。
每個片段除了正文,還保存文章路徑、標題、章節、分類、起訖行號、文件版本與片段識別碼。搜尋結果因此可以回到可核對的位置,不只剩一個相似度分數。
向量快取鍵包含 embedding 模型、文章標題、章節與片段文字。相同內容可重用既有向量;模型或送入文字改變時,才重新計算。下面是等價概念的偽程式碼,不是可直接部署的同步器。
key = sha256(model + title + heading + text)
vector = cached_vectors.get(key)
if vector is None:
    vector = embed(title + heading + text)

upsert_vector(chunk_id, vector, metadata)
publish_active_chunks(document_id, chunks)
更新時也要處理「新片段已生效,舊向量尚未清乾淨」的空窗。檢索端對照目前有效片段與不可用文件集合,過濾過期候選;背景再清理孤立資料。索引內存在某個向量,不等於它仍可拿來回答。
06|混合檢索:向量與關鍵詞怎麼合併
問題進來後,先決定範圍與查詢模式。一般語意問題與精確識別碼查詢有不同需求:前者需要找到說法不同但意義相近的內容,後者要保住原字串,不能任意模糊化。
向量路徑把問題交給 bge-m3,再到 Qdrant 查相似片段。關鍵詞路徑則查記憶體倒排索引:英文與符號識別碼保留為詞;中文以相鄰二字、三字片段建立詞項,另加完整字串與識別碼命中的分數。這是自行實作的 lexical scoring,不能直接把它叫成標準 BM25。
兩條排名先用 RRF 合併,再套來源角色調整與證據選取。簡化後的排名公式如下;缺席某個榜單的片段,該項分數視為零。
RRF(chunk) = 1 / (60 + vector_rank)
           + 1 / (60 + keyword_rank)
直接合併名次,可以避免把「向量相似度」和「關鍵詞分數」兩種不同尺度硬加在一起。這版還會檢查最低命中門檻,證據太弱就不勉強回答;精確查詢若指定識別碼根本不存在,也不以相似字串冒充命中。
最後送入模型的片段,不完全等同融合排名前幾名。系統會視情況補相鄰段落;如果命中的是文章末尾的來源列表,還要找同文件的摘要或結論,避免把「某文件被提到」誤當成「已讀到該文件的決策」。新版來源連結與時間線也需要另外處理。
07|一次問答的完整呼叫順序
以虛構問題「背景任務失敗後,怎麼判斷可以重試?」為例,主要路徑是下面七步。
- 瀏覽器送出問題與範圍;Python WebUI 驗證登入 session。
- WebUI 從已驗證身分取得 owner ID,連同內部服務憑證呼叫 RAG。瀏覽器不能自行宣告另一個 owner。
- RAG 建立 query ID、記錄開始事件,進行意圖分類與路由。
- 檢索器取得片段,保存候選排名、文件版本與最終入選證據。
- 生成器透過 Codex SDK 接收問題與來源,逐段產生答案;embedding 與回答由不同元件負責。
- RAG 用 NDJSON 回傳事件,WebUI proxy 逐行轉送,前端一邊顯示來源、一邊更新答案。
- 查詢結果、時間指標與回饋寫入 RAG 狀態庫,歷史查詢按 owner 隔離。
串流不是單純把最後答案拆幾段送出。它有明確事件種類,前端才能分辨仍在檢索、已開始回答或中途失敗。下列資料經縮減、值為虛構,展示的是契約形狀。
{"type":"status","query_id":"demo-q1","message":"正在檢索"}
{"type":"sources","query_id":"demo-q1","sources":[{"id":"S1","title":"重試原則"}]}
{"type":"answer_delta","query_id":"demo-q1","delta":"先確認操作是否具有冪等性。"}
{"type":"done","query_id":"demo-q1"}
來源不是前端提供任意路徑就能讀。使用者點引用時,服務以 query ID、source ID 與 owner 找到這次查詢已授權的來源,再取得內容。引用讀取因此沿用原查詢的邊界。
引用仍有一個要小心的實作細節:搜尋片段保存的是索引時的文件版本,點擊原文時文件可能已改動。保存版本與證據是追查基礎,但不能因此宣稱畫面原文永遠與生成時完全相同。
08|模型介面與多來源,不能只換設定
這套問答的生成器使用 Codex SDK。它與 OpenAI 相容的 HTTP completion 介面不是同一種呼叫方式;即使兩者都能「產生文字」,既有摘要、修補與審查函式也不會自動相容。
後續接入議題追蹤來源時,我把「候選檢索、原文回讀、來源融合」和「答案生成」分開。第二來源的檢索結果可以交給原生成器;不能順便把依賴另一種模型介面的整條摘要管線打開。
多來源還多出三個實作成本:離線建索引與即時回讀都必須套可見性規則;來源融合配額不能在只剩單一來源時無故砍掉結果;即時抓原文會增加查詢延遲。本圖畫的是核心 Markdown 路徑,這個擴充另外驗收,不能拿「抓到兩種來源」代表答案品質已通過。
09|權限與故障邊界怎麼落實
WebUI 使用登入驗證與 session,Agent API 使用有 scope、可撤銷的 Token。Token 明碼只在建立時交付,伺服器保存雜湊;能發布文章的 Token,也不等於能管理或核發其他 Token。
RAG sidecar 只供內部服務存取,維護介面與一般問答分開。索引範圍採允許清單,憑證、私鑰與秘密資料庫不進索引。這些是不同層的控制:查詢歷史按 owner 隔離,不代表所有文件都已具備逐篇 ACL;模型的唯讀設定,也不能拿來當作作業系統身分隔離的證明。
程序分離的直接效果,是 RAG 故障時,文章閱讀可以繼續運作。問答則明確回錯,不靜默更換 provider。外部來源的同步工作需要避免阻塞事件迴圈,否則背景同步就可能把查詢與健康檢查一起拖住。
| 驗證位置 | 實際核對 | 不能推論成什麼 |
|---|---|---|
| 程序與版本 | PID、啟動資訊、服務回報版本 | 本機 Git 更新不等於執行中的程式已更新 |
| 索引同步 | 文件版本、有效片段、失敗工作 | 索引完成不等於搜尋完整 |
| 檢索 trace | 範圍、候選、排名、入選理由 | 命中來源不等於答案採用正確 |
| 串流計時 | 檢索、首字、完整回答及瀏覽器接收 | 後端快不等於使用者已看到答案 |
| 回答驗收 | 引用是否支持結論、是否漏重要證據 | 回一題成功不等於全面品質通過 |
10|實作中最值得留下的取捨
我沒有把所有功能塞進同一個 Agent。檔案保存知識,服務層控制操作,排程負責整理,檢索器負責找證據,生成器負責組織回答。這個分工讓錯誤有地方可查,也讓某個元件可以單獨替換。
代價是需要維護多份狀態及它們之間的關係:文章 ID、文件版本、索引片段、query ID 與引用都要對得起來。真正花時間的地方,往往是重試、搬移、刪除、舊索引與服務重啟這些正常流程之外的情況。
這套實作沒有證明每一種問題都能答好,也沒有把自主補查或 GraphRAG 列為既有核心成果。它提供的是一條能追查的路徑:從哪篇文章開始、經過哪次索引、選了哪些片段,最後如何變成使用者看到的答案。
延伸閱讀:答案正確,還不夠:RAG 的來源驗收
延伸閱讀:先保持答案不變,再談檢索更快